 Henrique Matos
22 de abril de 2026 · 44 min de leitura
50 coisas que eu queria ter sabido antes
Esta é a lista que eu queria ter recebido quando comecei a colocar SaaS no meu próprio VPS. Nenhum desses conceitos é novo, mas a maioria a gente só leva a sério depois que dá errado em produção: o bug que não acontece no notebook, o deploy que derruba o app por alguns segundos, a cobrança que sai em dobro.
São 50 conceitos de backend, agrupados por tema. Cada um vem com uma analogia do dia a dia quando ajuda, um trecho de código em Node e Postgres e, no fim, a solução que eu usaria hoje e o porquê. Não precisa ler de uma vez: vale mais como guia para consultar quando o problema aparecer.
Concorrência e transações
Quase todo bug "que só acontece em produção" nasce aqui: duas requisições mexendo no mesmo dado ao mesmo tempo.
1. Condições de corrida (race conditions)
Duas operações concorrentes leem e escrevem o mesmo dado, e o resultado depende de quem chega primeiro.
Analogia: dois caixas vendem o último ingresso ao mesmo tempo, porque os dois viram "1 disponível".
// ERRADO: ler e depois escrever. Duas requisições leem stock=1 e as duas vendem
const { rows: [p] } = await db.query('SELECT stock FROM products WHERE id = $1', [id]);
if (p.stock > 0) await db.query('UPDATE products SET stock = stock - 1 WHERE id = $1', [id]);

// CERTO: operação atômica, o banco decide
const r = await db.query(
  'UPDATE products SET stock = stock - 1 WHERE id = $1 AND stock > 0 RETURNING stock', [id]);
if (r.rowCount === 0) throw new Error('Esgotado');
Melhor solução: empurrar a garantia para o banco, com um UPDATE condicional (
WHERE stock > 0), uma constraint UNIQUE ouSELECT ... FOR UPDATEquando a lógica for mais complexa. Por quê: o banco executa cada escrita de forma atômica, então some a janela entre ler e escrever onde a outra requisição entra. Locks em memória do Node não resolvem, porque com duas instâncias cada uma tem a sua memória e o problema volta.
2. Deadlocks
Duas transações esperam uma pela outra para sempre. O Postgres detecta e mata uma delas com o erro deadlock detected.
Analogia: dois carros num cruzamento estreito, cada um esperando o outro dar ré.
-- T1: UPDATE contas SET saldo = saldo - 10 WHERE id = 1;  -- trava a conta 1
-- T2: UPDATE contas SET saldo = saldo - 10 WHERE id = 2;  -- trava a conta 2
-- T1: UPDATE contas SET saldo = saldo + 10 WHERE id = 2;  -- espera T2
-- T2: UPDATE contas SET saldo = saldo + 10 WHERE id = 1;  -- espera T1 -> deadlock
Como evitar: travar sempre na mesma ordem (por exemplo, id crescente), manter transações curtas e fazer retry quando o erro aparecer.
Melhor solução: acessar e travar as linhas sempre na mesma ordem (por exemplo, ordenar os ids antes dos UPDATEs), manter as transações curtas e envolver a transação num retry automático para o erro
40P01. Por quê: deadlock só nasce quando duas transações travam recursos em ordens opostas; com ordem fixa, uma apenas espera a outra. Como algum deadlock raro ainda pode surgir sob carga, o retry transforma o erro num atraso de milissegundos que o usuário nem percebe.
3. Transações de banco de dados
Um grupo de operações que acontece por inteiro ou não acontece.
Analogia: transferência bancária. Debita e credita, ou nenhum dos dois.
const client = await pool.connect();
try {
  await client.query('BEGIN');
  await client.query('UPDATE contas SET saldo = saldo - 100 WHERE id = $1', [de]);
  await client.query('UPDATE contas SET saldo = saldo + 100 WHERE id = $1', [para]);
  await client.query('COMMIT');
} catch (e) {
  await client.query('ROLLBACK');
  throw e;
} finally {
  client.release();
}
Melhor solução: uma transação curta envolvendo só as escritas que precisam acontecer juntas, sem chamadas HTTP, envio de e-mail ou upload lá dentro; esses efeitos ficam para depois do COMMIT, via fila ou outbox. Por quê: enquanto está aberta, a transação segura locks e ocupa uma conexão do pool. Se houver dentro dela uma API que demora 10 segundos, outras requisições ficam bloqueadas e o pool esgota.
4. Propriedades ACID
As quatro garantias de uma transação:
- Atomicidade: tudo ou nada.
- Consistência: o banco sai de um estado válido para outro válido (constraints sempre respeitadas).
- Isolamento: transações simultâneas não atrapalham umas às outras (tópico 5).
- Durabilidade: depois do COMMIT, o dado sobrevive a uma queda de energia (gravado no WAL em disco).
Exemplo: no checkout, criar order + order_items + baixar estoque numa única transação. Se o servidor cair no meio, nada fica pela metade.
Melhor solução: usar um banco ACID, como o Postgres, como única fonte da verdade, e tratar Redis, índices de busca e filas como cópias derivadas que podem ser reconstruídas. Some a isso backups automáticos e testados, guardados fora do VPS (pgBackRest ou
pg_dumpagendado). Por quê: se um cache ou fila perde dados, você reconstrói a partir do banco; se o banco perde, não há de onde recuperar. É a forma mais barata de nunca perder dados de cliente.
5. Níveis de isolamento
Define quanto uma transação "enxerga" das outras que estão em andamento. Mais isolamento significa menos anomalias, porém mais conflitos e retries.
| Nível | O que garante | Custo |
|---|---|---|
| Read Committed (padrão no Postgres) | Só lê dados já commitados; ler duas vezes pode dar valores diferentes | Baixo |
| Repeatable Read (padrão no MySQL) | A transação vê uma "foto" fixa do banco do início ao fim | Médio; conflitos geram erro |
| Serializable | Resultado igual a rodar uma transação de cada vez | Alto; exige retry |
Existe também o Read Uncommitted (lê dados não commitados), mas no Postgres ele se comporta como Read Committed.
-- regra: no máximo 1 plantonista por dia
BEGIN ISOLATION LEVEL SERIALIZABLE;
SELECT count(*) FROM plantoes WHERE dia = '2026-10-25';  -- retorna 0
INSERT INTO plantoes (dia, medico) VALUES ('2026-10-25', 'ana');
COMMIT;
-- se outra transação fez o mesmo em paralelo, uma recebe o erro 40001 e tenta de novo.
-- em Read Committed, as duas passariam e o dia teria 2 plantonistas.
Melhor solução: manter o Read Committed padrão na grande maioria das operações e subir para Serializable, com retry no erro
40001, só onde há uma regra que envolve várias linhas (limites de plano, escalas, saldo agregado). Por quê: isolamento máximo em tudo gera mais conflitos, mais retries e menos throughput, sem ganho na maioria das telas. Nos poucos pontos com regras entre linhas, é exatamente o Serializable que impede anomalias que nenhum teste unitário pega.
6. Bloqueio otimista
Não trava nada. Guarda uma coluna version e, na hora de salvar, confere se ninguém alterou antes. Se alterou, falha e o usuário ou o código tenta de novo. Ideal quando conflito é raro (perfil, documentos, configurações).
Analogia: a wiki que avisa "alguém editou esta página enquanto você escrevia".
const r = await db.query(
  `UPDATE documentos SET conteudo = $1, version = version + 1
   WHERE id = $2 AND version = $3`, [conteudo, id, versionLida]);
if (r.rowCount === 0) throw new ConflictError('Alterado por outra pessoa'); // HTTP 409
Melhor solução: uma coluna
version(ouupdated_at) enviada junto com o formulário e conferida noWHEREdo UPDATE, devolvendo HTTP 409 quando não bater, para a interface avisar o usuário e oferecer recarregar. Por quê: edições em tela têm conflito raro e longos intervalos em que a pessoa está pensando, e travar a linha durante esse tempo seria inviável. O custo é só uma coluna e um tratamento de erro, e nenhuma alteração alheia é sobrescrita em silêncio.
7. Bloqueio pessimista
Trava a linha no momento da leitura e os outros esperam. Ideal quando conflito é frequente ou caro (saldo, estoque, reservas).
Analogia: pegar a chave do banheiro. Ninguém entra até você devolver.
BEGIN;
SELECT saldo FROM carteiras WHERE user_id = 42 FOR UPDATE;  -- outros esperam aqui
UPDATE carteiras SET saldo = saldo - 50 WHERE user_id = 42;
COMMIT;  -- libera a linha
Dica: FOR UPDATE SKIP LOCKED é ótimo para filas no Postgres. Cada worker pega um job diferente sem esperar pelos outros.
Melhor solução:
SELECT ... FOR UPDATEdentro de uma transação curta para saldo, estoque, assentos e reservas, eFOR UPDATE SKIP LOCKEDquando vários workers disputam itens de uma fila. Por quê: quando o conflito é provável, esperar a vez por alguns milissegundos sai mais barato que falhar e repetir várias vezes. A condição é a transação ser curta; um lock segurado por segundos vira fila de espera para o sistema inteiro.
Performance do banco
A maioria das lentidões de um SaaS está no banco, e quase sempre se resolve com índice certo, menos queries e um pool bem dimensionado.
8. Pool de conexões
Abrir conexão com o banco é caro (handshake, autenticação, um processo novo no Postgres). O pool mantém N conexões abertas e empresta uma para cada query.
Analogia: uma frota de táxis parada no ponto, em vez de fabricar um carro a cada corrida.
import pg from 'pg';
const pool = new pg.Pool({ max: 20, idleTimeoutMillis: 30_000, connectionTimeoutMillis: 2_000 });
await pool.query('SELECT 1'); // pega e devolve a conexão automaticamente
No VPS: o Postgres tem max_connections (padrão 100). Quatro instâncias do app com pool de 20 já usam 80. Com muitas instâncias, coloque o PgBouncer na frente.
Melhor solução: um pool por processo, dimensionado para que a soma de todas as instâncias fique abaixo do
max_connectionscom folga para migrações e acesso manual, com timeout de aquisição curto; quando o número de instâncias crescer, PgBouncer em modo transaction. Por quê: cada conexão do Postgres é um processo que consome memória, e mais conexões não significa mais velocidade. Acima de algumas dezenas o banco perde tempo alternando entre elas, então um pool pequeno e bem usado costuma ser mais rápido que um grande.
9. Consultas N+1
Busca uma lista (1 query) e depois faz uma query para cada item (N queries).
Analogia: ir ao mercado 50 vezes para comprar 50 itens.
// ERRADO: 1 + 50 queries
const posts = (await db.query('SELECT * FROM posts LIMIT 50')).rows;
for (const p of posts) {
  p.autor = (await db.query('SELECT * FROM users WHERE id = $1', [p.user_id])).rows[0];
}

// CERTO: 2 queries (ou um JOIN)
const ids = posts.map(p => p.user_id);
const users = await db.query('SELECT * FROM users WHERE id = ANY($1)', [ids]);
Em ORMs, use eager loading (include no Prisma, with no Drizzle). Em GraphQL, use DataLoader.
Melhor solução: carregar relações em lote (JOIN,
WHERE id = ANY($1)ou o eager loading do ORM), usar DataLoader em GraphQL e ligar o log de queries em desenvolvimento. Por quê: cada ida ao banco custa latência de rede, então 2 queries vencem 51 mesmo que cada uma seja rápida. O log em dev mostra o problema assim que ele nasce, antes de a tabela crescer e o endpoint ficar lento em produção.
10. Índices de banco de dados
Uma estrutura (geralmente B-tree) que permite achar linhas sem ler a tabela inteira.
Analogia: o índice remissivo no fim de um livro.
-- busca frequente: pedidos de um tenant, mais recentes primeiro
CREATE INDEX CONCURRENTLY idx_orders_tenant_created
  ON orders (tenant_id, created_at DESC);

-- índice parcial: indexa só o que interessa
CREATE INDEX idx_jobs_pending ON jobs (run_at) WHERE status = 'pending';
Custo: cada índice deixa INSERT e UPDATE mais lentos e ocupa disco. Num índice composto, a ordem importa: (tenant_id, created_at) serve para filtrar por tenant, mas não para filtrar só por data.
Melhor solução: criar índices a partir das queries reais (via
pg_stat_statementse EXPLAIN), com compostos na ordem dos filtros (igualdade primeiro, depois ordenação ou intervalo), e revisar de tempos em tempos os que nunca são usados empg_stat_user_indexes. Por quê: o índice certo transforma segundos em milissegundos, mas índice sem uso só ocupa disco e deixa toda escrita mais lenta. Em SaaS multi-tenant, quase todo índice importante começa portenant_id.
11. Otimização de consultas
Fazer o banco trabalhar menos. Checklist rápido:
- Selecione só as colunas que vai usar; evite
SELECT *em tabela larga. - Não aplique função na coluna indexada:
WHERE lower(email) = ...ignora o índice ememail(crie o índice emlower(email)). - Filtre e agregue no banco, não no JavaScript.
- Use paginação por cursor em vez de
OFFSETgrande.
-- lento: OFFSET 100000 lê e descarta 100 mil linhas
SELECT * FROM events ORDER BY id LIMIT 20 OFFSET 100000;

-- rápido: paginação por cursor (keyset)
SELECT * FROM events WHERE id > $1 ORDER BY id LIMIT 20;  -- $1 = último id da página anterior
Melhor solução: ativar o
pg_stat_statements, atacar primeiro as queries com maior tempo total (chamadas × duração) e validar cada mudança com EXPLAIN ANALYZE antes e depois. Por quê: a query que mais pesa raramente é a mais lenta; costuma ser uma rápida chamada milhares de vezes por minuto. Medir antes evita gastar horas otimizando algo que não muda nada no uso real do banco.
12. EXPLAIN ANALYZE
Mostra o plano que o banco escolheu e quanto tempo cada etapa levou de verdade, porque executa a query.
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM orders WHERE tenant_id = 7 ORDER BY created_at DESC LIMIT 20;
O que procurar na saída:
Seq Scannuma tabela grande: falta índice.rows=10estimado contrarows=50000real: estatísticas velhas, rodeANALYZE orders;.Sort Method: external merge Disk: ordenação foi para o disco; aumentework_memou indexe a ordenação.Index ScanouIndex Only Scan: bom sinal.
Cuidado: em UPDATE e DELETE ele executa de verdade. Envolva em BEGIN; ... ROLLBACK;.
Melhor solução: rodar
EXPLAIN (ANALYZE, BUFFERS)numa base com volume parecido com o de produção (ou numa réplica), comparar linhas estimadas com reais e usar um visualizador como explain.dalibo.com para planos grandes. Por quê: o planejador escolhe caminhos diferentes conforme o tamanho das tabelas, então o plano numa base de dev com 100 linhas engana. Quando a estimativa erra muito, a causa costuma ser estatística desatualizada, e um simplesANALYZEresolve.
Integridade e evolução do schema
Regras no banco protegem os dados mesmo quando o código erra; migrações bem feitas mudam essas regras sem derrubar o app.
13. Restrições de chave estrangeira (FK)
Garantem que uma referência aponta para algo que existe. Não dá para criar fatura de um cliente inexistente.
CREATE TABLE invoices (
  id bigserial PRIMARY KEY,
  customer_id bigint NOT NULL REFERENCES customers(id) ON DELETE RESTRICT
);
CREATE INDEX ON invoices (customer_id);  -- o Postgres NÃO cria este índice sozinho
ON DELETE CASCADE: apaga os filhos junto (post e seus comentários).ON DELETE RESTRICT: impede apagar o pai (cliente com faturas).ON DELETE SET NULL: só desliga a referência.
Sem o índice na coluna filha, cada DELETE no pai faz um scan completo na tabela filha.
Melhor solução: declarar FK em todas as relações, sempre com índice na coluna filha, usando
RESTRICTcomo padrão eCASCADEsó onde o filho realmente não faz sentido sem o pai. Por quê: o banco impede registros órfãos mesmo quando um script manual, um bug ou um job antigo passa por cima das regras do código. O índice evita que cada DELETE no pai varra a tabela filha inteira.
14. Restrições de unicidade
Impedem duplicatas no nível do banco. É a única proteção real contra a corrida "verifica se existe, depois insere".
ALTER TABLE users ADD CONSTRAINT users_email_key UNIQUE (email);

-- multi-tenant: e-mail único dentro de cada tenant, sem diferenciar maiúsculas
CREATE UNIQUE INDEX ON members (tenant_id, lower(email));

-- só uma assinatura ativa por usuário (soft delete)
CREATE UNIQUE INDEX ON subscriptions (user_id) WHERE canceled_at IS NULL;// deixa o banco resolver a corrida
await db.query('INSERT INTO users (email) VALUES ($1) ON CONFLICT (email) DO NOTHING', [email]);Melhor solução: declarar a unicidade no banco (constraint ou índice único, parcial quando houver soft delete) e tratar a duplicata com
ON CONFLICTou capturando o erro23505para devolver uma mensagem amigável. Por quê: a checagem "já existe?" no código sempre perde para duas requisições simultâneas, e o resultado são contas ou assinaturas duplicadas. A constraint é a única garantia que vale ao mesmo tempo para todas as instâncias, scripts e jobs.
15. Migrações de banco de dados
Mudanças de schema versionadas como código, aplicadas em ordem e registradas numa tabela de controle.
-- migrations/20261024_add_plan_to_tenants.sql
ALTER TABLE tenants ADD COLUMN plan text NOT NULL DEFAULT 'free';
Ferramentas: Prisma Migrate, Drizzle Kit, Knex, Flyway, golang-migrate. Regra de ouro: migração já aplicada em produção nunca é editada; crie uma nova.
Melhor solução: migrações versionadas no repositório, revisadas no PR, rodadas automaticamente como um passo separado do deploy (antes de subir o código novo) e nunca editadas depois de aplicadas. Por quê: todo ambiente, do notebook à produção, fica com exatamente o mesmo schema, de forma reproduzível. Rodar como passo separado evita que várias instâncias tentem aplicar a mesma migração ao mesmo tempo no startup.
16. Migrações sem downtime
Durante o deploy, a versão antiga e a nova do app rodam juntas. A migração precisa funcionar com as duas. O padrão é expand, migrate, contract.
Exemplo: renomear name para full_name:
- Expand: adiciona
full_name(nullable). Deploy do código que grava nas duas colunas. - Migrate: preenche os dados antigos em lotes (
UPDATE ... WHERE id BETWEEN 1 AND 10000). - Deploy do código que lê só
full_name. - Contract: numa migração posterior, remove
name.
Armadilhas no Postgres:
CREATE INDEXbloqueia escritas: useCREATE INDEX CONCURRENTLY.- Adicionar
NOT NULLdireto faz um scan com lock: crieCHECK (col IS NOT NULL) NOT VALIDe depoisVALIDATE CONSTRAINT. - Comece cada migração com
SET lock_timeout = '5s';para ela desistir em vez de enfileirar o app inteiro atrás de um lock.
Melhor solução: seguir expand, migrate, contract, com
SET lock_timeout,CREATE INDEX CONCURRENTLY, constraintsNOT VALIDseguidas deVALIDATEe backfill em lotes pequenos. Por quê: durante o deploy, a versão antiga e a nova do app rodam juntas, então cada passo precisa ser compatível com as duas. As opções de lock evitam o cenário clássico em que um ALTER simples enfileira todas as queries atrás dele e derruba o app por minutos.
Escalando o banco
A ordem saudável costuma ser: índices, máquina maior, réplicas de leitura, particionamento e, só no fim, sharding.
17. Réplicas de leitura
Cópias do banco principal que só aceitam leitura. Escritas vão para o primário; relatórios, dashboards e buscas vão para as réplicas.
Analogia: um professor escreve no quadro e vários monitores tiram as dúvidas dos alunos a partir da cópia.
const primary = new pg.Pool({ connectionString: process.env.DATABASE_URL });
const replica = new pg.Pool({ connectionString: process.env.DATABASE_REPLICA_URL });

await primary.query('INSERT INTO orders ...');                 // escrita
const relatorio = await replica.query('SELECT ... GROUP BY ...'); // leitura pesada
Melhor solução: adicionar réplica só quando leituras pesadas (relatórios, exports, dashboards) começarem a atrapalhar o primário, roteando explicitamente apenas essas queries para ela. Por quê: réplica traz atraso de dados e mais um servidor para manter, atualizar e monitorar, e antes disso índices e um primário maior costumam resolver. Quando chegar a hora, ela ainda serve de base para failover e backups, o que ajuda a justificar o custo.
18. Atraso de replicação (replication lag)
A réplica recebe as mudanças com milissegundos, ou segundos sob carga, de atraso.
Sintoma clássico: o usuário salva o perfil, a página recarrega lendo da réplica e mostra o valor antigo.
Soluções:
- Read-your-writes: depois que o usuário escreve, leia do primário por alguns segundos (marque na sessão).
- Leituras críticas (saldo, permissões, status de pagamento) sempre no primário.
- Monitore o atraso na réplica:
SELECT now() - pg_last_xact_replay_timestamp();
Melhor solução: aplicar read-your-writes (ler do primário por alguns segundos depois que o usuário escreve), manter leituras críticas como saldo, permissões e pagamento sempre no primário, e alertar quando o lag passar de um limite. Por quê: o atraso continua existindo, mas desaparece exatamente onde o usuário perceberia ou onde um dado velho causaria erro. O alerta pega os casos em que a réplica ficou para trás por carga ou rede, antes de virar reclamação.
19. Sharding de banco de dados
Dividir os dados entre vários bancos independentes, cada um com uma fatia (por exemplo, por tenant_id). Serve para quando um único servidor não aguenta mais o volume de escrita.
Analogia: vários cartórios, cada um responsável por alguns bairros.
// tabela de roteamento: facilita mover um tenant de shard depois
const { rows: [{ shard }] } = await catalog.query('SELECT shard FROM tenant_shards WHERE tenant_id = $1', [tid]);
const db = shards[shard];
await db.query('SELECT * FROM orders WHERE tenant_id = $1', [tid]);
Custo alto: JOINs e transações entre shards ficam difíceis, e rebalancear dá trabalho. Para SaaS num VPS, é o último recurso. Ferramentas: Citus (Postgres) e Vitess (MySQL).
Melhor solução: adiar o máximo possível e, se chegar lá, shardar por
tenant_idcom uma tabela de roteamento tenant → shard, ou usar o Citus para o Postgres fazer isso por você. Por quê: em SaaS quase toda query já filtra por tenant, então cada requisição fica dentro de um único shard, sem JOINs entre servidores. A tabela de roteamento permite mover um cliente grande para um shard dedicado sem redistribuir todos os outros.
20. Particionamento
Dividir uma tabela grande em pedaços dentro do mesmo banco. O banco lê só as partições relevantes, e apagar dados antigos vira um DROP instantâneo.
CREATE TABLE events (
  id bigserial, tenant_id bigint, created_at timestamptz NOT NULL, payload jsonb
) PARTITION BY RANGE (created_at);

CREATE TABLE events_2026_10 PARTITION OF events
  FOR VALUES FROM ('2026-10-01') TO ('2026-11-01');

-- retenção de 12 meses: sem DELETE gigante, sem bloat
DROP TABLE events_2025_10;
Ótimo para logs, eventos, auditoria e métricas. A extensão pg_partman cria as partições futuras automaticamente.
Diferença: particionamento acontece dentro de um servidor; sharding espalha por vários servidores.
Melhor solução: particionar por mês (ou por semana, se o volume for alto) as tabelas que só crescem, como logs, eventos, auditoria e métricas, deixando o
pg_partmancriar as partições futuras e remover as antigas. Por quê: a retenção vira umDROPinstantâneo em vez de um DELETE gigante que gera bloat e locks. As queries do dia a dia, que olham dados recentes, leem só uma ou duas partições pequenas.
Cache
Cache troca consistência por velocidade; o trabalho difícil é decidir quando o dado guardado deixou de valer.
21. Invalidação de cache
Saber quando o dado em cache ficou velho e removê-lo. Três estratégias comuns:
- TTL: expira sozinho depois de X segundos. Simples, mas aceita dado velho por um tempo.
- Invalidação na escrita: ao atualizar o banco, apaga a chave.
- Chave versionada:
user:42:v7; quando muda, incrementa a versão e a chave antiga morre sozinha.
// cache-aside + invalidação na escrita
async function getUser(id) {
  const hit = await redis.get(`user:${id}`);
  if (hit) return JSON.parse(hit);
  const user = await db.findUser(id);
  await redis.set(`user:${id}`, JSON.stringify(user), 'EX', 300);
  return user;
}

async function updateUser(id, data) {
  await db.updateUser(id, data);
  await redis.del(`user:${id}`); // apague em vez de atualizar: evita gravar valor velho numa corrida
}
Melhor solução: cache-aside com TTL curto (minutos) combinado com
DELda chave logo depois da escrita no banco, usando nomes de chave previsíveis (entidade:id). Por quê: o DEL resolve o caso normal na hora, e o TTL funciona como rede de segurança se alguma invalidação falhar ou for esquecida. Apagar em vez de atualizar evita que uma corrida grave no cache um valor mais velho que o do banco.
22. Evicção no Redis
Quando o Redis chega no maxmemory, a política de evicção decide o que jogar fora.
| Política | O que faz | Quando usar |
|---|---|---|
noeviction (padrão) |
Recusa novas escritas com erro | Filas e dados que não podem sumir |
allkeys-lru |
Remove as chaves usadas há mais tempo | Cache puro |
allkeys-lfu |
Remove as chaves menos usadas no geral | Cache com itens populares estáveis |
volatile-lru |
Só remove chaves que têm TTL | Redis misto: cache + dados persistentes |
# redis.conf
maxmemory 512mb
maxmemory-policy allkeys-lru
Dica de VPS: o BullMQ exige noeviction, senão o Redis pode apagar jobs. O ideal é uma instância para cache e outra para filas.
Melhor solução: rodar duas instâncias (podem ser dois containers no mesmo VPS): uma com
allkeys-lrue sem persistência para cache, e outra comnoevictione AOF ligado para filas e locks. Por quê: cache e fila precisam de comportamentos opostos, porque um deve descartar dados para abrir espaço e o outro nunca pode perder um job. Numa instância só, ou o cache trava com erro de memória ou a fila perde jobs em silêncio.
23. Estampidas de cache (cache stampede)
Uma chave muito acessada expira e milhares de requisições vão ao banco ao mesmo tempo para recriá-la.
Analogia: as portas da loja abrem na Black Friday e todo mundo corre para o mesmo balcão.
Soluções:
- Lock: só uma requisição recalcula; as outras esperam um pouco.
- TTL com jitter:
300 + aleatório(0..60)segundos, para as chaves não expirarem todas juntas. - Refresh antecipado: renovar em background antes de expirar (stale-while-revalidate).
async function getComLock(key, ttl, carregar, tentativas = 20) {
  const v = await redis.get(key);
  if (v) return JSON.parse(v);

  const dono = await redis.set(`lock:${key}`, '1', 'NX', 'EX', 10); // só um consegue
  if (!dono && tentativas > 0) {
    await sleep(100);
    return getComLock(key, ttl, carregar, tentativas - 1);
  }
  try {
    const dado = await carregar();
    const ttlComJitter = ttl + Math.floor(Math.random() * 60);
    await redis.set(key, JSON.stringify(dado), 'EX', ttlComJitter);
    return dado;
  } finally {
    if (dono) await redis.del(`lock:${key}`);
  }
}
Melhor solução: TTL com jitter em todas as chaves e, nas chaves muito acessadas, lock de recálculo ou stale-while-revalidate (servir o valor antigo enquanto um único processo atualiza em background). Por quê: o jitter espalha as expirações no tempo, e o lock garante que só uma requisição vai ao banco para recriar a chave. Com stale-while-revalidate o usuário nunca espera o recálculo, o que é ideal para dashboards e páginas públicas.
24. Cache distribuído
Cache compartilhado entre todas as instâncias do app (Redis, Memcached), em vez da memória local de cada processo.
Por quê: com 3 instâncias atrás do load balancer, um Map em memória fica diferente em cada uma. Invalidar numa não invalida nas outras.
| Cache local (em memória) | Cache distribuído (Redis) | |
|---|---|---|
| Latência | Nanossegundos | Cerca de 0,2 a 1 ms (rede) |
| Igual em todas as instâncias | Não | Sim |
| Sobrevive a restart do app | Não | Sim |
Padrão comum: dois níveis. L1 local com TTL curtíssimo (5 s) e L2 no Redis. Para invalidar o L1 em todas as instâncias, publique a chave num canal do Redis Pub/Sub.
Melhor solução: usar o Redis como cache principal compartilhado entre as instâncias e deixar o cache local em memória só para dados quase imutáveis (configurações, feature flags, planos), com TTL de poucos segundos. Por quê: com várias instâncias, só um cache compartilhado garante que todas vejam o mesmo valor depois de uma invalidação. O cache local continua útil onde alguns segundos de atraso não fazem mal, e economiza idas ao Redis.
Resiliência
A rede falha, APIs externas caem e clientes repetem requisições; estes seis padrões fazem o sistema aguentar isso sem duplicar cobranças nem cair junto.
25. Idempotência
Executar a mesma operação 2 ou 10 vezes dá o mesmo resultado que executar uma vez. GET, PUT e DELETE são idempotentes por definição; POST não é.
Analogia: o botão do elevador. Apertar 5 vezes não chama 5 elevadores.
app.post('/payments', async (req, res) => {
  const key = req.header('Idempotency-Key'); // UUID gerado pelo cliente

  // reserva a chave; a UNIQUE impede duas execuções simultâneas
  const r = await db.query(
    `INSERT INTO idempotency (key, status) VALUES ($1, 'processing')
     ON CONFLICT (key) DO NOTHING`, [key]);

  if (r.rowCount === 0) { // já vimos essa chave
    const { rows: [row] } = await db.query('SELECT status, response FROM idempotency WHERE key = $1', [key]);
    return row.status === 'done' ? res.json(row.response) : res.status(409).send('Em processamento');
  }

  const pagamento = await cobrar(req.body);
  await db.query(`UPDATE idempotency SET status = 'done', response = $2 WHERE key = $1`, [key, pagamento]);
  res.json(pagamento);
});
O Stripe usa exatamente este header Idempotency-Key na API dele.
Melhor solução: exigir um header
Idempotency-Keyem todo POST que cobra, cria recurso ou dispara envio, reservando a chave com UNIQUE no banco e guardando a resposta por 24 horas; no front, gerar a chave uma vez por intenção do usuário (por exemplo, ao abrir o checkout). Por quê: retries de rede, cliques duplos e reenvios passam a devolver a mesma resposta em vez de criar cobranças duplicadas. É a base que torna seguros todos os retries dos tópicos seguintes.
26. Mecanismos de retry
Tentar de novo quando a falha é temporária: timeout, 502, 503, conexão recusada, deadlock. Nunca repita erros permanentes (400, 401, 404, validação), e só repita operações idempotentes.
async function comRetry(fn, maxTentativas = 5) {
  for (let tentativa = 1; ; tentativa++) {
    try {
      return await fn();
    } catch (e) {
      if (tentativa >= maxTentativas || !ehTransitorio(e)) throw e;
      await sleep(esperaComJitter(tentativa)); // tópicos 27 e 28
    }
  }
}
Melhor solução: centralizar os retries num helper que só repete erros transitórios (timeout, 429, 502, 503, conexão recusada, deadlock), apenas em operações idempotentes, com limite de tentativas, backoff com jitter e respeito ao header
Retry-After. Por quê: retry sem critério multiplica a carga justamente quando o serviço já está doente, e repetir um POST não idempotente pode duplicar efeitos. Com um helper único, a política fica igual em todo o código e fácil de ajustar.
27. Backoff exponencial
Esperar cada vez mais entre as tentativas (1 s, 2 s, 4 s, 8 s...) até um teto. Dá tempo para o serviço se recuperar em vez de bombardeá-lo.
const espera = (tentativa, base = 1000, teto = 30_000) =>
  Math.min(teto, base * 2 ** (tentativa - 1)); // 1s, 2s, 4s, 8s, 16s, 30s, 30s...
Melhor solução: backoff exponencial com base entre 100 ms e 1 s, teto (por exemplo 30 s) e número máximo de tentativas, ajustado ao contexto: poucas tentativas rápidas em requisições de usuário e mais tentativas espaçadas em jobs de fundo. Por quê: dá tempo para o serviço se recuperar sem bombardeá-lo e sem deixar ninguém esperando para sempre. Um usuário na tela não pode esperar minutos, mas um job pode tentar de novo por horas sem prejuízo.
28. Jitter
Aleatoriedade no tempo de espera. Sem jitter, mil clientes que falharam juntos tentam de novo juntos (no segundo 1, 2, 4...), criando picos sincronizados.
Analogia: depois de um apagão, se todo mundo religa o ar-condicionado no mesmo segundo, a luz cai de novo.
// "full jitter": um valor aleatório entre 0 e o backoff
const esperaComJitter = (tentativa) => Math.random() * espera(tentativa);
Melhor solução: full jitter, ou seja, esperar um tempo aleatório entre 0 e o valor do backoff (
Math.random() * backoff). Por quê: na análise conhecida da AWS sobre o tema, é a variante que melhor espalha as tentativas e a que gera menos trabalho total no servidor. Sem jitter, clientes que falharam juntos voltam juntos em ondas sincronizadas, e o serviço cai de novo justamente quando ia se recuperar.
29. Circuit breakers
Um disjuntor em volta das chamadas a um serviço externo. Se ele falha demais, o circuito abre e as chamadas falham na hora, sem esperar timeout. Isso protege seu app e dá folga ao serviço doente.
Os três estados:
- Fechado: tudo normal; conta as falhas.
- Aberto: falha imediatamente (ou devolve um fallback) por X segundos.
- Meio-aberto: deixa passar uma chamada de teste. Deu certo, fecha; falhou, abre de novo.
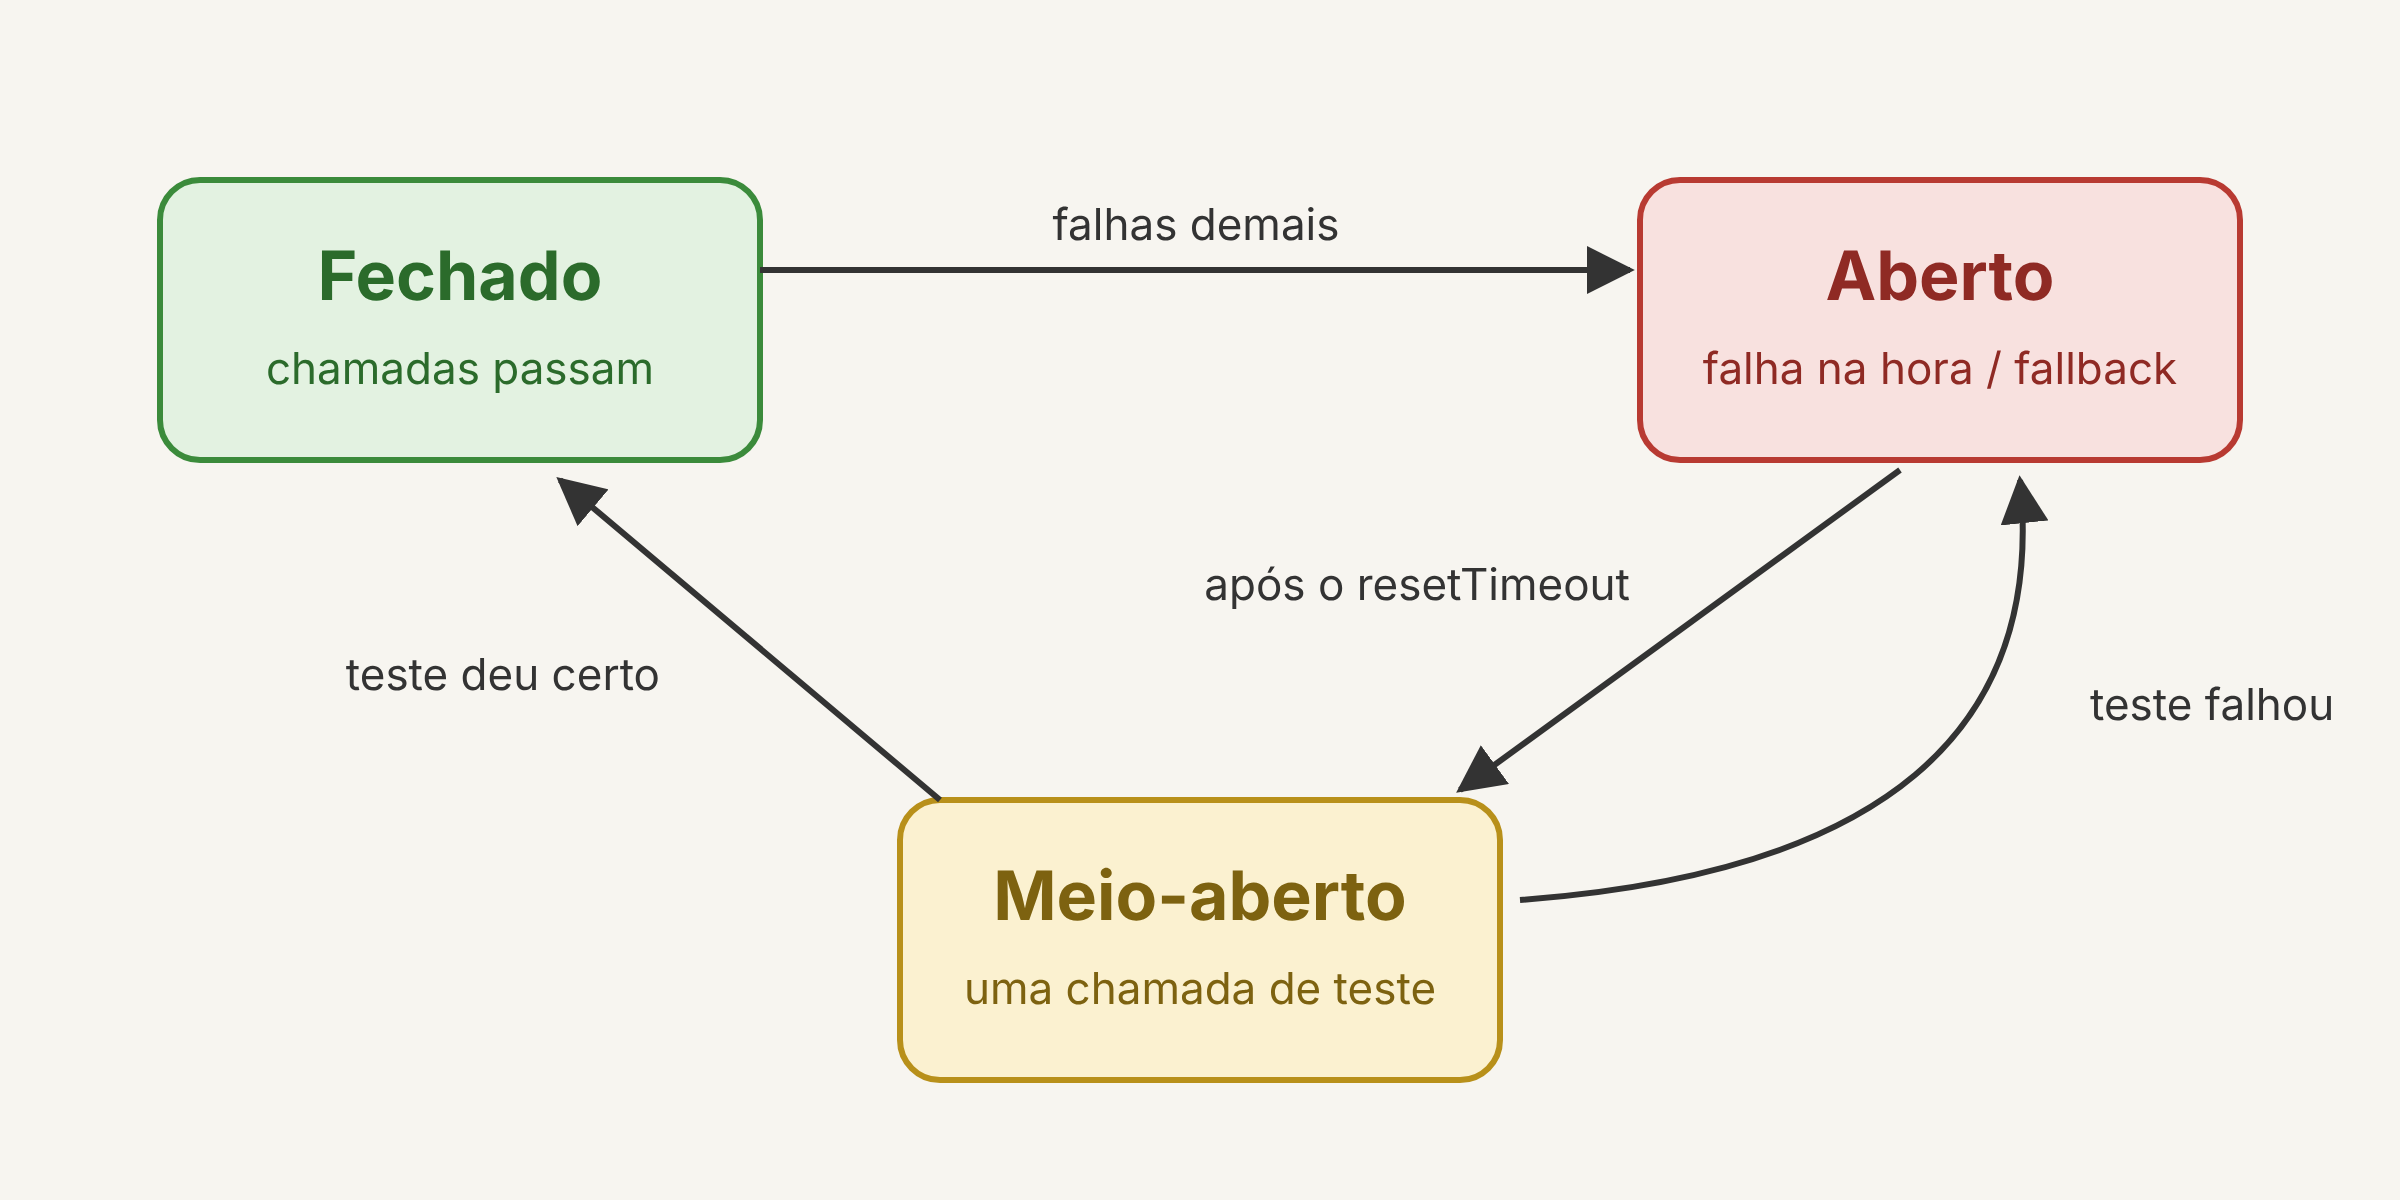 Os três estados de um circuit breaker
Verde é a operação normal, vermelho protege o app enquanto o serviço está doente, e amarelo decide se ele já se recuperou.
import CircuitBreaker from 'opossum';

const breaker = new CircuitBreaker(calcularFreteNaApi, {
  timeout: 3000,                // mais de 3 s conta como falha
  errorThresholdPercentage: 50, // 50% de erro abre o circuito
  resetTimeout: 30_000,         // após 30 s, testa no modo meio-aberto
});
breaker.fallback(() => ({ frete: null, aviso: 'Frete calculado no checkout' }));

const frete = await breaker.fire(cep);
Melhor solução: um breaker por dependência externa (gateway de pagamento, API de frete, provedor de e-mail, LLM), com timeout curto, fallback útil (valor em cache, mensagem amigável ou enfileirar para depois) e alerta quando o circuito abrir. Por quê: sem ele, uma API lenta prende conexões e workers esperando timeouts, e o seu app cai junto com ela. Com ele, a falha fica contida naquela funcionalidade e o resto do SaaS continua funcionando.
30. Limitação de taxa (rate limiting)
Limitar quantas requisições um cliente faz por período. Protege contra abuso, brute force e o cliente "barulhento" que derruba os outros tenants. Algoritmos comuns: janela fixa, janela deslizante e token bucket (permite rajadas curtas).
// janela fixa com Redis: 100 requisições por minuto por API key
async function permitido(apiKey) {
  const chave = `rl:${apiKey}:${Math.floor(Date.now() / 60_000)}`;
  const n = await redis.incr(chave);
  if (n === 1) await redis.expire(chave, 60);
  return n <= 100; // false -> HTTP 429 com header Retry-After
}
No Nginx, dá para barrar antes de chegar no Node: limit_req_zone $binary_remote_addr zone=api:10m rate=10r/s;
Melhor solução: duas camadas: limite por IP no Nginx ou Caddy para barrar abuso barato, e token bucket no Redis por tenant ou API key para aplicar os limites de cada plano, sempre respondendo 429 com
Retry-Aftere headers de limite restante. Por quê: o proxy barra ataques e brute force antes de gastar CPU do Node, e o Redis garante o mesmo limite em todas as instâncias. Limitar por tenant impede que um cliente barulhento derrube os outros.
Infra e escala
Num VPS, escale primeiro na vertical e use um proxy reverso com várias instâncias do app para aproveitar todos os núcleos.
31. Balanceamento de carga
Distribuir as requisições entre várias instâncias do app. Algoritmos: round-robin (um para cada), least connections (quem está mais livre) e hash por IP (mesmo cliente, mesma instância).
upstream app {
  least_conn;
  server 127.0.0.1:3001;
  server 127.0.0.1:3002;
  server 127.0.0.1:3003 max_fails=3 fail_timeout=30s; # tira do rodízio se falhar
}
server {
  listen 443 ssl;
  location / { proxy_pass http://app; }
}
Mesmo num único VPS isso ajuda: o Node usa um núcleo por processo, então 4 processos aproveitam 4 vCPUs. Ferramentas: Nginx, HAProxy, Traefik, Caddy.
Melhor solução: um proxy (Nginx, Caddy ou Traefik) com
least_conn, remoção automática de instâncias que falham e checagem ativa do endpoint de readiness (nativa no Caddy e no Traefik). Por quê:least_connmanda cada requisição para quem está mais livre, o que funciona melhor que round-robin quando algumas requisições demoram muito mais que outras. Tirar do rodízio quem falha faz com que um deploy ou uma instância travada não vire erro para o usuário.
32. Escalabilidade horizontal
Adicionar mais instâncias ou máquinas. Pré-requisito: app stateless. Sessão no Redis ou JWT, uploads no S3/MinIO, nada importante no disco local ou na memória do processo.
Analogia: abrir mais caixas no supermercado.
docker compose up -d --scale app=4Prós: quase sem teto e tolera a queda de uma instância. Contras: mais peças (load balancer, cache compartilhado, deploys coordenados).
Melhor solução: manter o app stateless desde o primeiro dia (sessões no Redis ou JWT, arquivos no S3 ou MinIO, nada importante no disco ou na memória do processo) e escalar adicionando containers atrás do proxy. Por quê: quando o tráfego crescer, adicionar capacidade vira um comando em vez de um refactor às pressas. Mesmo num único VPS, várias instâncias permitem deploy sem downtime, trocando uma de cada vez.
33. Escalabilidade vertical
Colocar mais CPU, RAM ou disco na mesma máquina, por exemplo, um VPS de 4 vCPU/8 GB passa para 16 vCPU/64 GB.
Analogia: trocar o caixa por um funcionário mais rápido.
Prós: zero mudança de código e nenhuma complexidade distribuída. Contras: tem teto, costuma exigir reboot e continua sendo um ponto único de falha.
Para o banco de um SaaS pequeno ou médio, escalar na vertical é quase sempre o primeiro passo certo. Um Postgres bem configurado numa máquina boa aguenta muito mais do que parece.
Melhor solução: escalar na vertical primeiro, principalmente o banco, até o custo ou o limite da máquina começar a pesar, ajustando o Postgres ao novo hardware (
shared_buffers,work_mem,effective_cache_size). Por quê: é o jeito mais simples e barato de ganhar capacidade, sem mudança de código nem complexidade distribuída. O cuidado é ter backups e um plano de restauração testado, porque continua sendo um ponto único de falha.
34. Proxies reversos
Um servidor na frente das suas aplicações. Recebe as requisições da internet e repassa para dentro. Cuida de HTTPS, compressão, arquivos estáticos, rate limit e roteamento por domínio, e esconde as portas internas.
Analogia: a recepção do prédio. O visitante fala com a recepção e nunca anda sozinho pelos andares.
# Caddyfile: HTTPS automático com Let's Encrypt
app.meusaas.com {
  reverse_proxy localhost:3000
}
api.meusaas.com {
  reverse_proxy localhost:4000
}
Proxy reverso e load balancer: balancear entre várias instâncias é só uma das funções de um proxy reverso.
Melhor solução: Caddy, pelo HTTPS automático e configuração mínima, ou Traefik, se você quer descobrir containers pelos labels do Docker, ficando na frente de tudo com apenas as portas 80 e 443 abertas no firewall. Por quê: centraliza TLS, roteamento, compressão e limites num só lugar e esconde as portas internas do app, do banco e do Redis. Menos superfície exposta significa menos chance de alguém achar um Postgres ou Redis aberto na internet.
Processamento assíncrono
Tudo que é lento ou pode falhar (e-mail, PDF, IA, integrações) sai da requisição HTTP e vai para uma fila processada por workers.
35. Filas de mensagens
Um produtor coloca mensagens numa fila e consumidores processam no próprio ritmo. Desacopla quem pede de quem faz e absorve picos de tráfego.
Analogia: a comanda da lanchonete. O caixa anota e segue atendendo; a cozinha prepara na ordem.
import { Queue } from 'bullmq';
const emails = new Queue('emails', { connection: redis });

app.post('/signup', async (req, res) => {
  const user = await criarUsuario(req.body);
  await emails.add('boas-vindas', { userId: user.id },
    { attempts: 5, backoff: { type: 'exponential', delay: 1000 } });
  res.status(201).json(user); // a resposta não espera o servidor SMTP
});
Ferramentas: BullMQ (Redis), pg-boss (Postgres), RabbitMQ, NATS, SQS e Kafka (log de eventos).
Melhor solução: BullMQ se você já tem Redis, ou pg-boss se prefere manter tudo no Postgres; RabbitMQ ou Kafka só quando houver uma necessidade concreta, como vários serviços em linguagens diferentes ou volume muito alto de eventos. Por quê: os dois primeiros cobrem retries, atrasos, prioridades e agendamento sem subir mais um sistema no VPS. Cada peça a mais é algo para atualizar, monitorar e incluir no backup.
36. Filas de cartas mortas (DLQ)
Para onde vão as mensagens que falharam depois de todas as tentativas. Evita perder a mensagem e impede que uma mensagem "venenosa" fique em loop travando a fila.
Analogia: a caixa de cartas não entregues dos Correios.
const worker = new Worker('emails', processar, { connection: redis });

worker.on('failed', async (job, err) => {
  if (job.attemptsMade >= job.opts.attempts) {
    await dlq.add('email-falhou', { original: job.data, erro: err.message });
    // alerta no Slack/Discord; alguém investiga, corrige e reenvia
  }
});
No RabbitMQ e no SQS isso é configuração nativa (x-dead-letter-exchange e redrivePolicy).
Melhor solução: todo job que esgota as tentativas vai para uma DLQ (no BullMQ, o próprio conjunto de jobs
failedserve, desde que não seja apagado automaticamente), com alerta no Slack ou Discord e um comando ou botão para reprocessar depois da correção. Por quê: nenhuma falha some em silêncio e uma mensagem ruim não fica em loop travando a fila. O reprocessamento permite corrigir o bug e recuperar os jobs perdidos sem pedir nada ao cliente.
37. Workers em segundo plano
Processos separados da API que consomem as filas e fazem o trabalho pesado: e-mails, PDFs, thumbnails, importação de CSV, chamadas a IA.
// worker.js: roda em outro processo ou container
import { Worker } from 'bullmq';

new Worker('pdf', async (job) => {
  const pdf = await gerarFatura(job.data.invoiceId);
  await storage.upload(`faturas/${job.data.invoiceId}.pdf`, pdf);
}, { connection: redis, concurrency: 5 });# docker-compose.yml
services:
api:
build: .
command: node server.js
worker:
build: .
command: node worker.js
deploy:
replicas: 2Vantagem: API e workers escalam de forma independente, e um PDF lento nunca trava uma requisição HTTP.
Melhor solução: workers em containers próprios, usando a mesma imagem da API com outro comando,
concurrencyajustada ao tipo de trabalho (alta para I/O, baixa para CPU) e graceful shutdown. Por quê: API e workers escalam separados, e um job pesado nunca rouba CPU de uma requisição HTTP. Com o desligamento gracioso, deploys não deixam jobs pela metade.
38. Agendamento de tarefas
Rodar tarefas em horários fixos ou recorrentes: cobrança mensal, relatório diário, limpeza de sessões expiradas, aviso de fim do trial.
// BullMQ: job repetível, todo dia às 03:00 UTC
await queue.add('limpar-sessoes', {}, {
  repeat: { pattern: '0 3 * * *', tz: 'UTC' },
});
Armadilha: com 3 instâncias do app, um node-cron dentro do código roda 3 vezes. Soluções:
- Agendar pela fila (o BullMQ garante uma execução por horário).
- Um único container dedicado ao agendador.
- Um lock no Postgres:
SELECT pg_try_advisory_lock(42);e só quem conseguir executa.
Torne o job idempotente também: se rodar duas vezes, não pode cobrar duas vezes.
Melhor solução: agendar pela fila, com os jobs repetíveis do BullMQ ou o
scheduledo pg-boss, e escrever cada job agendado de forma idempotente. Por quê: a fila garante uma execução por horário mesmo com várias instâncias e sobrevive a restarts, ao contrário de um cron em memória. A idempotência cobre o caso raro de execução duplicada, para nunca haver cobrança em dobro.
Eventos e integrações
Eventos deixam partes do sistema reagirem sem se conhecerem; webhooks são esses eventos cruzando a fronteira entre empresas, e por isso precisam de assinatura e deduplicação.
39. Arquitetura orientada a eventos
Um serviço avisa que algo aconteceu (sempre no passado: pedido.pago) e quem tiver interesse reage. O emissor não sabe quem está ouvindo.
Analogia: o sinal da escola toca e cada turma sabe o que fazer. O sinal não liga para cada sala.
// o emissor não conhece os interessados
await bus.publish('pedido.pago', { pedidoId: 123, valor: 99.9 });

// cada consumidor reage de forma independente
bus.subscribe('pedido.pago', enviarRecibo);
bus.subscribe('pedido.pago', liberarAcesso);
bus.subscribe('pedido.pago', atualizarMetricas); // adicionado depois, sem tocar no checkout
Prós: baixo acoplamento; adicionar uma reação nova não mexe no código existente. Contras: o fluxo fica mais difícil de seguir e depurar (daí o tracing, tópico 50) e os dados ficam eventualmente consistentes.
Melhor solução: começar com eventos dentro de um monolito modular, usando fila e outbox, e só extrair serviços quando um módulo realmente precisar escalar ou ser implantado separado. Por quê: você ganha o desacoplamento (adicionar reações novas sem mexer no checkout) sem o custo de operar, versionar e depurar vários serviços. Para uma pessoa ou equipe pequena com um VPS, esse custo operacional é o que mais pesa.
40. Verificação de webhooks
Garantir que o webhook veio de quem diz ter vindo e não de alguém forjando a requisição. O emissor assina o corpo com um segredo compartilhado (HMAC-SHA256); você recalcula a assinatura e compara.
import crypto from 'node:crypto';

app.post('/webhooks/provedor', express.raw({ type: 'application/json' }), (req, res) => {
  const recebida = req.header('X-Signature') ?? '';
  const esperada = crypto.createHmac('sha256', process.env.WEBHOOK_SECRET)
    .update(req.body) // corpo CRU: JSON re-serializado muda os bytes e quebra a assinatura
    .digest('hex');

  const ok = recebida.length === esperada.length &&
    crypto.timingSafeEqual(Buffer.from(recebida), Buffer.from(esperada)); // evita timing attack
  if (!ok) return res.status(401).end();

  const evento = JSON.parse(req.body);
  // ...
});
Inclua um timestamp na assinatura e rejeite eventos com mais de 5 minutos, para evitar replay. Com Stripe, use stripe.webhooks.constructEvent, que já faz tudo isso.
Melhor solução: usar o SDK oficial do provedor (como
stripe.webhooks.constructEvent) sobre o corpo cru da requisição; nos webhooks que o seu SaaS envia, assinar com HMAC-SHA256 incluindo um timestamp. Por quê: o SDK já valida assinatura e timestamp e faz a comparação em tempo constante, sem você reinventar criptografia. O erro mais comum é parsear o JSON antes de verificar, o que muda os bytes e faz toda assinatura falhar.
41. Retries de webhooks
Quando você recebe: o provedor reenvia se você não responder 2xx rapidamente. O mesmo evento pode chegar várias vezes e fora de ordem.
- Responda 200 rápido e processe numa fila.
- Deduplique pelo ID do evento.
- Não confie na ordem: confira o estado atual (ex.: ignore
assinatura.atualizadamais antiga que a última aplicada).
const r = await db.query(
  'INSERT INTO webhook_events (event_id, payload) VALUES ($1, $2) ON CONFLICT DO NOTHING',
  [evento.id, evento]);
if (r.rowCount === 0) return res.sendStatus(200); // duplicado: já recebido
await fila.add('processar-webhook', { eventId: evento.id });
res.sendStatus(200);
Quando o seu SaaS envia webhooks para clientes:
- Fila com backoff exponencial e jitter (por exemplo 1 min, 5 min, 30 min, 2 h, 12 h).
- Desative o endpoint depois de muitas falhas seguidas e avise o cliente por e-mail.
- Mostre um painel com o histórico de entregas e um botão de reenviar.
Melhor solução: ao receber, gravar o evento pelo ID único, responder 200 em milissegundos e processar numa fila de forma idempotente, conferindo o estado atual em vez de confiar na ordem de chegada. Por quê: duplicatas viram no-op, o provedor nunca recebe timeout e eventos fora de ordem não sobrescrevem dados novos com antigos. Ao enviar, fila com backoff, histórico de entregas e botão de reenvio reduzem muito os chamados de suporte.
Sistemas distribuídos
Quando os dados vivem em mais de um lugar, "tudo ou nada" deixa de ser gratuito; estes padrões recuperam garantias suficientes sem uma transação global.
42. Consistência eventual
Depois de uma mudança, nem todas as partes do sistema mostram o valor novo na hora, mas todas convergem em pouco tempo.
Analogia: você troca a foto de perfil e seus amigos veem a nova alguns segundos depois.
Exemplos do dia a dia: réplica de leitura com atraso, índice de busca (Meilisearch, Elasticsearch) atualizado por fila, contador de likes recalculado a cada minuto.
Na interface: atualização otimista (mostra o novo valor na hora) e estados como "processando...".
Melhor solução: aceitar consistência eventual onde o usuário não percebe (busca, métricas, contadores, e-mails, notificações) e manter consistência forte em dinheiro, permissões e limites de plano, mostrando estados como "processando" quando houver espera. Por quê: é nos dados de dinheiro e acesso que um valor velho causa prejuízo real ou falha de segurança. Nos demais, alguns segundos de atraso são invisíveis e permitem um sistema bem mais simples e rápido.
43. Transações distribuídas
Uma operação que precisa ser atômica em vários bancos ou serviços, por exemplo cobrar no serviço de pagamentos e reservar no serviço de estoque.
- 2PC (two-phase commit): um coordenador pergunta "todos prontos?" e depois manda "commit". Garantido, mas lento, e trava tudo se o coordenador cair. Raro em microsserviços.
- Saga: uma sequência de transações locais. Se uma etapa falha, rodam ações compensatórias que desfazem as anteriores.
Saga "Checkout"
1. Reservar estoque   -> compensação: liberar estoque
2. Cobrar cartão      -> compensação: estornar
3. Criar envio        -> FALHOU
   => executa: estornar, depois liberar estoque
Regra prática: se dá para manter tudo num único Postgres, mantenha. É de longe a solução mais simples.
Melhor solução: evitar, mantendo no mesmo Postgres os dados que precisam mudar juntos; quando envolver um serviço externo (um gateway de pagamento, por exemplo), usar uma saga com compensações e chave de idempotência em cada passo. Por quê: 2PC é frágil, lento e trava recursos se o coordenador cair, enquanto uma transação local é simples e confiável. A saga aceita que algo pode falhar no meio e já define como desfazer cada passo.
44. Padrão Outbox
Resolve o "salvei no banco, mas o evento não foi publicado" (ou o contrário). Em vez de publicar direto na fila, grava o evento numa tabela outbox na mesma transação do dado. Um processo separado lê a outbox e publica.
// 1. dado + evento na mesma transação: os dois ou nenhum
await db.tx(async (t) => {
  const pedido = await t.one('INSERT INTO pedidos (...) VALUES (...) RETURNING *');
  await t.none('INSERT INTO outbox (tipo, payload) VALUES ($1, $2)', ['pedido.criado', pedido]);
});

// 2. relay: roda em loop num worker
await db.tx(async (t) => {
  const eventos = await t.any(`
    SELECT * FROM outbox WHERE publicado_em IS NULL
    ORDER BY id LIMIT 100 FOR UPDATE SKIP LOCKED`);
  for (const e of eventos) await fila.add(e.tipo, e.payload);
  await t.none('UPDATE outbox SET publicado_em = now() WHERE id = ANY($1)', [eventos.map(e => e.id)]);
});
Garante entrega "pelo menos uma vez", então os consumidores precisam ser idempotentes. Alternativa sem polling: CDC com Debezium lendo o WAL do Postgres.
Melhor solução: gravar o evento numa tabela outbox na mesma transação do dado e publicar com um relay usando
FOR UPDATE SKIP LOCKED, limpando as linhas já publicadas periodicamente. Por quê: nenhum evento se perde e nenhum evento sai sem que o dado tenha sido salvo, sem precisar de nada além do Postgres que você já tem. Como a entrega é "pelo menos uma vez", os consumidores precisam ser idempotentes.
45. CQRS
Separar o modelo de escrita (commands: valida regras, grava normalizado) do modelo de leitura (queries: dados prontos para a tela, desnormalizados).
Analogia: a cozinha e o cardápio. O cliente lê o cardápio sem precisar saber como a cozinha se organiza.
// command: regra de negócio nas tabelas normalizadas
async function finalizarPedido(cmd) { /* valida, grava pedido + itens, emite evento */ }

// projeção: mantém uma tabela pronta para o dashboard
on('pedido.finalizado', (e) => db.query(
  `INSERT INTO dashboard_vendas (tenant_id, dia, total) VALUES ($1, $2, $3)
   ON CONFLICT (tenant_id, dia) DO UPDATE SET total = dashboard_vendas.total + $3`,
  [e.tenantId, e.dia, e.valor]));

// query: leitura trivial e rápida
const vendas = await db.query('SELECT * FROM dashboard_vendas WHERE tenant_id = $1', [tid]);
Versão leve: uma MATERIALIZED VIEW atualizada de tempos em tempos já separa leitura de escrita. Só vale o esforço quando leitura e escrita têm necessidades bem diferentes.
Melhor solução: aplicar só onde dói: tabelas de leitura atualizadas por eventos, ou materialized views com
REFRESH MATERIALIZED VIEW CONCURRENTLY, para os dashboards e relatórios pesados, deixando o resto do sistema com um modelo único. Por quê: você ganha leituras rápidas onde importa sem reescrever o domínio inteiro nem manter dois modelos para cada tela. CQRS completo só compensa quando leitura e escrita têm cargas e formatos muito diferentes.
46. Event Sourcing
Em vez de guardar só o estado atual, guarda todos os eventos que aconteceram. O estado é calculado reproduzindo os eventos.
Analogia: o extrato bancário. O saldo é a soma de todas as movimentações.
// tabela append-only: nunca UPDATE, nunca DELETE
const eventos = [
  { conta: 42, tipo: 'Depositado', valor: 100 },
  { conta: 42, tipo: 'Sacado',     valor: 30 },
  { conta: 42, tipo: 'Depositado', valor: 50 },
];

const saldo = eventos.reduce((s, e) =>
  e.tipo === 'Depositado' ? s + e.valor : s - e.valor, 0); // 120
Prós: auditoria completa, "viagem no tempo" e a possibilidade de criar visões novas a partir do histórico. Contras: complexo, evoluir o formato dos eventos é difícil, precisa de snapshots e quase sempre vem junto com CQRS. Use onde o histórico é o produto (financeiro, contabilidade); na maioria dos SaaS, uma tabela audit_log resolve.
Melhor solução: na maioria dos SaaS, não usar; manter tabelas normais e uma
audit_logappend-only que registra quem fez o quê, quando, e os valores antes e depois. Por quê: isso entrega a auditoria e o histórico que o negócio costuma pedir por uma fração da complexidade. Event sourcing de verdade só compensa onde o histórico é o próprio produto, como contabilidade, carteiras e ledgers.
Operação em produção
Estes quatro fazem a diferença entre um deploy tranquilo e um incidente às 3 da manhã: segurar a carga, desligar com cuidado, saber quem está saudável e enxergar onde o tempo vai.
47. Backpressure
Quando o consumidor não dá conta, ele sinaliza ao produtor para desacelerar, em vez de acumular tudo na memória até estourar.
Analogia: a esteira do supermercado. Se o caixa não acompanha, a esteira para e você espera para colocar mais compras.
// streams do Node já fazem backpressure: a leitura pausa se a escrita estiver lenta
import { pipeline } from 'node:stream/promises';
await pipeline(fs.createReadStream('import.csv'), parseCsv(), salvarEmLotes());

// workers: concurrency limita quanto se puxa da fila por vez
new Worker('import', processar, { connection: redis, concurrency: 10 });
Na API, devolver 429 ou 503 com Retry-After quando a fila interna está cheia é backpressure aplicado ao cliente.
Melhor solução: colocar limites em todo ponto (tamanho do pool,
concurrencydos workers, streams em vez de carregar arquivos inteiros, tamanho máximo de filas em memória) e responder 429 ou 503 comRetry-Afterquando estiver cheio. Por quê: recusar cedo e de forma controlada é muito melhor que o processo morrer sem memória e derrubar todas as requisições em andamento. O cliente recebe um sinal claro para tentar depois, em vez de um timeout.
48. Desligamento gracioso (graceful shutdown)
Ao receber o sinal de parada (deploy, restart), o processo para de aceitar trabalho novo, termina o que está em andamento e fecha as conexões. Sem isso, ele morre no meio de uma requisição ou de um job.
const server = app.listen(3000);

process.on('SIGTERM', async () => {
  setTimeout(() => process.exit(1), 25_000).unref(); // nunca fica pendurado
  server.close();        // para de aceitar conexões novas
  await worker.close();  // espera os jobs em andamento
  await pool.end();      // fecha o Postgres
  await redis.quit();
  process.exit(0);
});
Detalhes no Docker:
- O Docker manda
SIGTERMe, após 10 s,SIGKILL. Ajuste comstop_grace_period. - Com
npm startnoCMD, o sinal pode não chegar ao Node. UseCMD ["node", "server.js"]ouinit: true. - Marque o readiness como falho primeiro (tópico 49), para o proxy parar de mandar tráfego.
Melhor solução: no SIGTERM, marcar o readiness como falho, esperar alguns segundos para o proxy parar de mandar tráfego, drenar requisições e jobs em andamento, fechar conexões e ter um timeout de segurança menor que o
stop_grace_period. Por quê: deploys e restarts deixam de derrubar requisições e jobs no meio. Sem isso, cada deploy gera um pequeno pico de erros 502 e jobs repetidos que ninguém sabe explicar.
49. Verificações de saúde (health checks)
Endpoints que dizem se a instância está viva e pronta. São dois tipos:
- Liveness (
/healthz): o processo responde? Se não, reinicia o container. - Readiness (
/readyz): consegue atender agora (banco e Redis acessíveis)? Se não, o load balancer para de mandar tráfego, sem reiniciar.
app.get('/healthz', (req, res) => res.send('ok'));

app.get('/readyz', async (req, res) => {
  try {
    await Promise.all([pool.query('SELECT 1'), redis.ping()]);
    res.send('ready');
  } catch {
    res.status(503).send('not ready');
  }
});# docker-compose.yml
healthcheck:
test: ["CMD", "wget", "-qO-", "http://localhost:3000/healthz"]
interval: 10s
timeout: 3s
retries: 3Cuidado: não coloque o banco no liveness. Se o Postgres cair, reiniciar o app em loop não resolve nada. Para monitorar de fora, o Uptime Kuma roda bem no próprio VPS.
Melhor solução: liveness simples e sem dependências para reiniciar processos travados, readiness checando banco e Redis para tirar a instância do balanceador, e um monitor rodando fora do VPS (Uptime Kuma em outra máquina ou um serviço de uptime) para avisar quando tudo cai. Por quê: cada um responde a uma pergunta diferente: o processo está vivo, a instância pode receber tráfego e o usuário consegue acessar. Misturar os dois primeiros causa reinícios em loop sempre que o banco oscila.
50. Rastreamento distribuído (distributed tracing)
Seguir uma requisição de ponta a ponta através de serviços, filas e bancos. Cada requisição ganha um trace ID, e cada etapa vira um span com início, duração e atributos. O resultado é uma cascata que mostra onde o tempo foi gasto.
POST /checkout                        820 ms
|- auth middleware                      5 ms
|- SELECT carrinho (Postgres)          12 ms
|- POST api.pagamentos.com            640 ms   <- o gargalo
|- fila.add('email')                    3 ms
|- worker: enviar-email 300 ms (mesmo trace, outro processo)// tracing.js: carregue antes de tudo -> node --import ./tracing.js server.js
import { NodeSDK } from '@opentelemetry/sdk-node';
import { getNodeAutoInstrumentations } from '@opentelemetry/auto-instrumentations-node';
import { OTLPTraceExporter } from '@opentelemetry/exporter-trace-otlp-http';
new NodeSDK({
serviceName: 'api',
traceExporter: new OTLPTraceExporter({ url: 'http://localhost:4318/v1/traces' }),
instrumentations: [getNodeAutoInstrumentations()], // http, express, pg e redis automáticos
}).start();O ID viaja entre serviços no header traceparent (padrão W3C). Para self-host: Jaeger, Grafana Tempo ou SigNoz. Grave o trace ID em cada linha de log para pular do log para o trace com um clique.
Melhor solução: OpenTelemetry com auto-instrumentação na API e nos workers, exportando para Grafana Tempo ou SigNoz no seu VPS, com o trace ID gravado em cada linha de log. Por quê: é o padrão aberto, sem lock-in de fornecedor, e já cobre HTTP, Express, Postgres e Redis sem mudar o código. Ligar log e trace pelo mesmo ID transforma a pergunta "por que esse checkout demorou?" em um clique.